سرویس اختصاصی WebScraper.ir
برای سایت یا منبع شما، ربات استخراج اختصاصی میسازیم
وقتی دادهتان داخل یک سایت، پنل یا سامانه خاص است و ابزار آماده کافی نیست، برای همان منبع رباتی میسازیم که استخراج، بررسی و تحویل را خودکار انجام دهد.
ابتدا منبع بررسی میشود؛ سپس روی نمونه واقعی تست و تحویل میگردد.
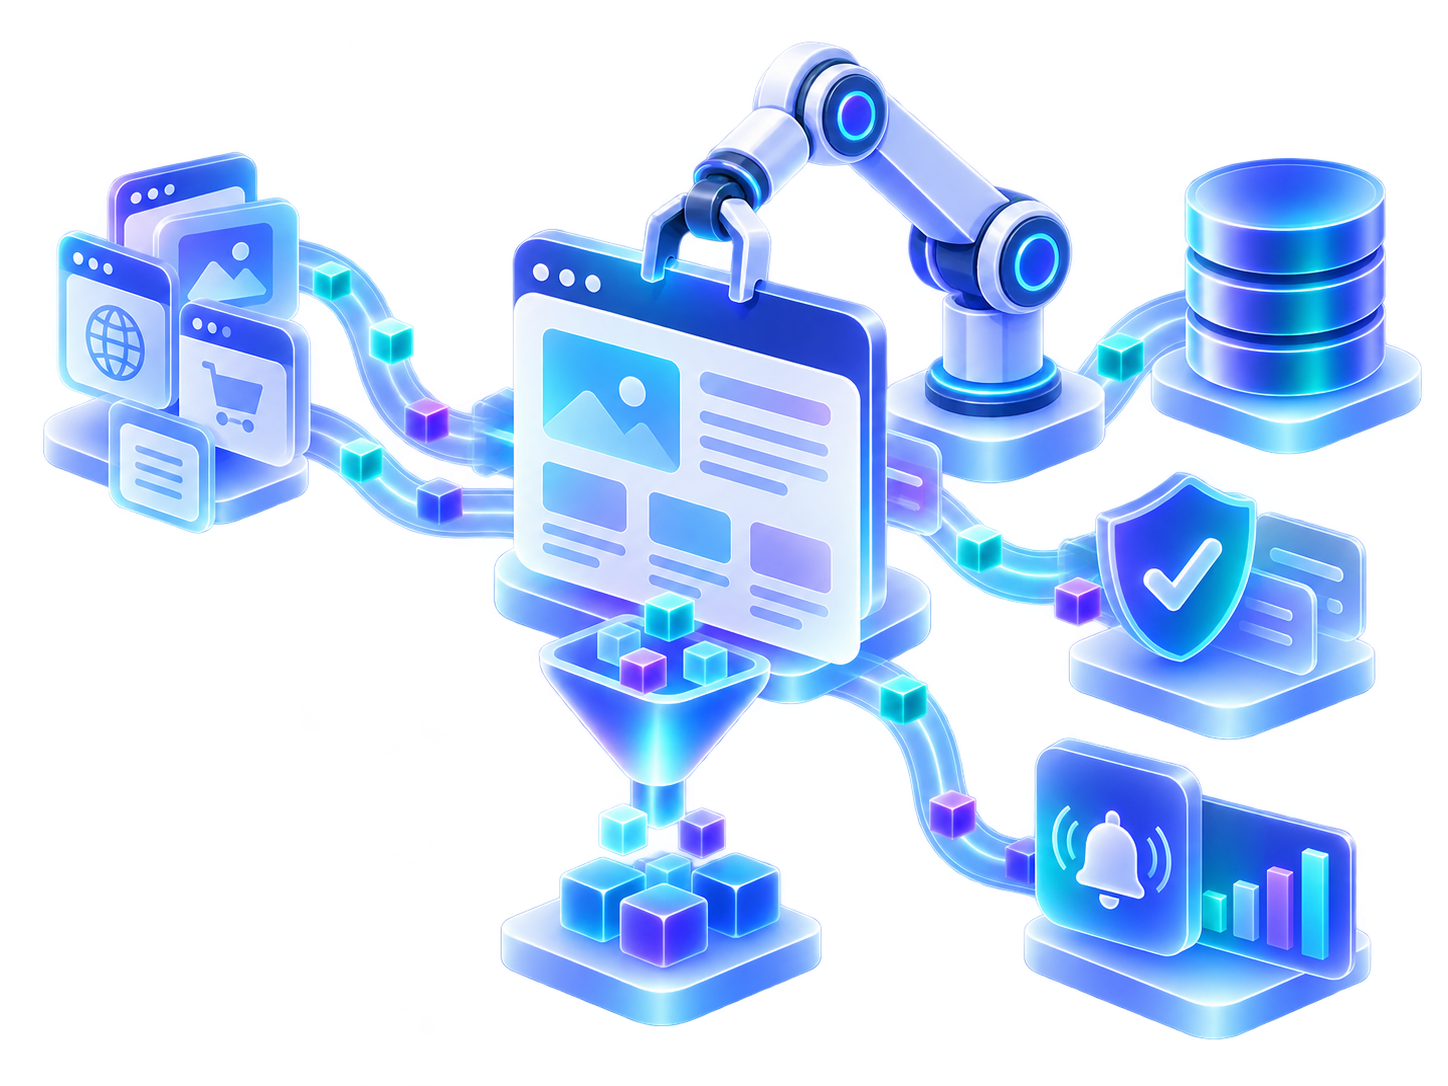
- منبع
- سایت، پنل، فایل
- خروجی
- JSON، Excel، DB، API
- اجرای
- زمانبندی + هشدار
- تحویل
- سورس و مستندات
کاربردهای واقعی
دقیقاً چه کاری میتوانیم برای شما انجام دهیم؟
مثال ۱ — استخراج از یک سایت خاص
سایتی دارید که محصولات یا اطلاعات خاصی دارد و میخواهید هر روز — یا هر چند ساعت — دادههایش را بگیرید.
سایت هدف ← ربات استخراج ← داده تمیز ← Excel / JSON / Database
مثلاً نام محصول، قیمت، موجودی، تصویر، دستهبندی و لینک — بدون کپی دستی صفحهبهصفحه توسط اپراتور.
مثال ۲ — استخراج از پنل نیازمند ورود
اطلاعات داخل پنل تأمینکننده یا سامانه داخلی است و عمومی نیست.
ورود ← صفحات موردنظر ← استخراج ← ذخیره خروجی
در محدوده فنی توافقشده؛ برای نشست، صفحه پویا یا ورود دو مرحلهای، در امکانسنجی معماری مناسب (مثلاً مرورگر خودکار) انتخاب میشود.
مثال ۳ — فایل + وب با هم
گاهی داده از یک منبع نمیآید — مثلاً Excel روزانه تأمینکننده بههمراه سایت محصولات.
Excel ← اطلاعات پایه ← سایت ← تکمیل فیلدها ← خروجی نهایی
یک خط واحد بهجای دو فرایند دستی جدا.
مثال ۴ — اجرای خودکار روزانه
مثلاً هر شب ساعت ۲ دادهها بهروز شوند.
زمانبندی ← اجرای Scraper ← کنترل کیفیت ← ذخیره ← گزارش اجرا
اگر اجرای شبانه مشکل داشت، برای تیم شما هشدار ثبت میشود.
مثال ۵ — اگر سایت تغییر کرد چه؟
ساختار صفحه عوض میشود و Scraper ناگهان خطا میدهد — پروژه باید قابل نگهداری باشد، نه فقط یک فایل یکبار مصرف.
تغییر انتخابگر ← تشخیص خطا ← ثبت اجرا ← هشدار
گزارش اجرا، هشدار انحراف و نگهداری قراردادی در محدوده سرویس پیشبینی میشود.
مثال ۶ — قبل از استخراج کامل، پایلوت
پروژه باید صدها هزار رکورد جمع کند؛ اول مستقیم سراغ کل حجم نمیرویم.
۱۰۰ رکورد نمونه ← بررسی کیفیت ← تأیید شما ← اجرای کامل
پایلوت روی نمونه واقعی و چکلیست پذیرش قبل از مقیاسدهی.
مثال ۷ — تحویل به دیتابیس یا API
خروجی لزوماً فایل نیست — داده مستقیم به سیستم شما میرود.
Scraper ← <a href="https://www.postgresql.org/docs/" target="_blank" rel="noopener">PostgreSQL</a> ← API ← سیستم شما
یا Scraper ← JSON / CSV، یا Scraper ← Database ← داشبورد.
مثال ۸ — تحویل سورس به تیم شما
میخواهید پروژه روی زیرساخت خودتان اجرا و نگهداری شود.
Source Code + <a href="https://docs.docker.com/" target="_blank" rel="noopener">Docker</a> + README + تنظیمات اجرا
تیم فنی شما مخزن کد، اجرا و بهروزرسانی را در اختیار دارد.
به زبان ساده: شما منبع و داده موردنیاز را مشخص میکنید؛ ما رباتی میسازیم که همان داده را خودکار، قابل کنترل و قابل نگهداری استخراج کند.
شروع ساده
شما فقط ۳ چیز را مشخص کنید
-
منبع چیست؟
مثلاً:
- سایت عمومی
- پنل نیازمند ورود
- API
- فایل
- پورتال داخلی
- سامانه سازمانی
-
چه دادهای میخواهید؟
مثلاً:
- قیمت
- محصول
- خبر
- آگهی
- موجودی
- اطلاعات مشتری
- هر فیلد مشخص دیگر
-
خروجی را کجا میخواهید؟
مثلاً:
- Excel
- JSON
- Database
- API
- Dashboard
- <a href="https://telegram.org" target="_blank" rel="noopener">Telegram</a> / Email alert
کدی مینویسیم که همان صفحات و ستونهایی را که در امکانسنجی بستید استخراج کند — با نگهداری قراردادی وقتی سایت منبع عوض شد.
در یک نگاه
اسکریپر دقیقاً برای سایت و فیلدهای شما
نتیجهٔ عملی
تحویل قابل اجرا در محیط شما
مثال: اجرای روزانه روی سرور شما، خروجی JSON یا Excel
کد، Dockerfile در صورت نیاز، و راهنمای اجرا — مالکیت با شماست.
- محدوده فقط منابع و فیلدهای توافقشده؛ تغییر گستردهٔ سایت منبع فاز جداگانه است.
- کیفیت نمونه خروجی تأییدشده قبل از تحویل نهایی و تست روی حجم واقعی پروژه.
معرفی
ربات استخراج اختصاصی یعنی مهندسی خط، نه یک فایل Python روی لپتاپ
انتخاب Playwright در برابر Scrapy به پویایی صفحه، ورود و توان عملیاتی بستگی دارد — در امکانسنجی صریح میگوییم کدام لایه برای منبع شما هزینه و پایداری بهتری دارد.
تحویل سورس به معنی بینیاز شدن از بهروزرسانی انتخابگر نیست؛ قرارداد نگهداری، هشدار انحراف و SLA جدا تعریف میشود تا محیط اصلی قابل پیشبینی بماند.
محدودیت ضدربات، CAPTCHA و محدودیت درخواست روی انتخاب لایه (Requests، Scrapy، Playwright) و هزینه نگهداری اثر دارد؛ در امکانسنجی معماری پیشنهادی و ریسک فنی را شفاف گزارش میکنیم.
چکلیست پذیرش: N رکورد نمونه که تیم شما امضا میکند — قبل از مقیاسدهی و زمانبندی در محیط اصلی.
قبل و بعد از خط کارگاهی
قبل — اسکریپت موردی
- یک فایل بدون ساختار داده و بدون ثبت گزارش خطا
- انتخابگر میشکند — کسی هشدار نمیگیرد
- توسعه روی Windows، محیط عملیاتی روی سرور دیگر
بعد — خط استخراج قابل ممیزی
- امکانسنجی تا هشدار با قرارداد فیلد مشخص
- کنترل کیفیت رکورد + گزارش ناموفق و انحراف
- Docker، README و نمونه متغیر محیط برای عملیات فنی
مخاطب
این سرویس برای چه تیمی معنا دارد؟
سه نقش رایج — در امکانسنجی با منبع، خروجی و مدل تحویل شما همتراز میکنیم.
خروجی تمیز با ساختار داده ثابت
فیلدهای توافقشده، اعتبارسنجی قبل از ذخیره و نمونه JSON برای تست خط پردازش داخلی — بدون غافلگیری در ستونهای DB.
- ساختار داده
- کنترل کیفیت
- خروجیگیری
مخزن کد، Docker و ثبت گزارش هر اجرا
سورس در Git شما، cron یا Celery، تلاش مجدد و هشدار — یا نگهداری روی سرور روی VPS/سرور ما با گزارش دسترسپذیری خط.
- Docker
- CI
- نگهداری
منبع منحصربهفرد بدون API رسمی
پورتال سازمانی، منبع قدیمی یا ترکیب فایل + وب — پایلوت ۱۰۰ رکورد قبل از تعهد مقیاسدهی و قرارداد نگهداری.
- پایلوت
- SLA
- پذیرش
محدوده
دقیقاً چه چیزی داخل قرارداد است؟
طراحی، ساخت و تحویل خط استخراج — نه مالکیت داده منبع یا ضمانت تغییر نکردن سایت سرویس بیرونی.
داخل محدوده قرارداد
- امکانسنجی منبع، ساختار HTML/API، نشست و خروجی هدف
- پیادهسازی کشف → استخراج → اعتبارسنجی → ذخیره → هشدار
- پایلوت روی نمونه واقعی و چکلیست پذیرش
- Docker، README، نمونه متغیر محیط و تحویل سورس در Git توافقی
- ثبت گزارش اجرا، تلاش مجدد خطای موقت و هشدار انحراف انتخابگر
- زمانبندی cron/Celery و استقرار اولیه روی سرور توافقی
خارج از محدوده قرارداد
- CAPTCHA یا ضدربات بدون مسیر فنی پایدار در امکانسنجی
- ضمانت دسترسپذیری یا ثبات چیدمان سایت سرویس بیرونی
- مشاوره حقوقی استفاده از داده یا مجوز محتوا
- نگهداری نامحدود بدون قرارداد SLA
- تبدیل خودکار هر منبع دنیا بدون امکانسنجی جدا
تأخیر
چه چیزهایی خط را کند یا متوقف میکند؟
توان عملیاتی روی اسلاید تبلیغاتی ≠ زمان واقعی اجرا در محیط اصلی — در طراحی صریح میگوییم کجا گلوگاه و ریسک انحراف داریم.
پویایی صفحه و ورود
برنامه تکصفحهای، احراز هویت دو مرحلهای، نشست کوتاه — Playwright سنگینتر از Scrapy
محدودیت درخواست و خزش
محدودسازی نرخ در معماری، صف و سقف درخواست توافقی
اعتبارسنجی و کنترل کیفیت
ساختار داده سختگیرانه — رکوردهای ناموفق بیشتر ولی داده تمیزتر
CAPTCHA و ضدربات
انتخاب لایه (HTTP، مرورگر، پروکسی) — روی هزینه و زمان اثر مستقیم دارد
تغییر چیدمان منبع
انحراف انتخابگر — هشدار و قرارداد نگهداری
کاربرد
کاربردهای رایج ربات استخراج اختصاصی
پورتال پشت VPN
اطلاعات ورود امن سازمان شما — استخراج با Playwright و ثبت گزارش دسترسی.
HTML قدیمی
تجزیهگر مقاوم با جایگزین و تست پایش یکنواختی روی نمونه ثابت صفحه.
فایل + وب
دریافت روزانه + استخراج تکمیلی — یک خط پردازش واحد.
نگهداری روی سرور ۲۴/۷
اجرای زمانبندیشده روی سرور ما — گزارش اجرا و هشدار.
ورودی API داخلی
ذخیره ← REST با سرویس توسعه API در معماری مشترک.
اتوماسیون گزارش
خلاصه کنترل کیفیت و رکوردهای ناموفق به Slack یا ایمیل — با اتوماسیون گردش کار.
تحویل
خط را چطور تحویل و اجرا میکنید؟
همان خروجیهایی که تیم شما واقعاً برای استقرار و ممیزی نیاز دارد.
سورس + Git
مخزن با شاخه محافظتشده، تاریخچه تمیز و بازبینی کد داخلی شما.
Docker
ایمیج و compose نمونه — توسعه و عملیاتی یکسان.
گزارش اجرا / DB
متادیتای اجرا و رکوردها در PostgreSQL یا فایل خروجی.
نگهداری روی سرور
اجرای زمانبندیشده، پایش و اصلاح انتخابگر طبق SLA.
فرایند
از امکانسنجی تا تحویل و نگهداری
-
امکانسنجی
URL، ساختار منبع، ورود و خروجی هدف
-
پایلوت
~۱۰۰ رکورد + چکلیست پذیرش
-
مهندسی خط
استخراج، اعتبارسنجی، ذخیره، هشدار
-
تحویل
Git، Docker، README
-
نگهداری
SLA، انحراف و مقیاسدهی پردازشگر
گروهبندی در ثبت گزارش و گزارش اجرا
ستونها در نگاشت قرارداد با تیم شما ثبت میشود.
run_idduration_secsource
records_okrecords_failedqc_pass_pct
pipelinealertssample_record
دادهها
فیلدهای گزارش اجرا و رکورد
نام فیلدها در خروجی فنی همانطور که در جدول است؛ توضیح فارسی برای تیم داده، عملیات فنی و پذیرش تحویل.
run_id
شناسه یکتا هر اجرا
source
نام منبع یا پروفایل قراردادی
pipeline
مراحل فعال در این اجرا
records_ok / records_failed
شمارش بعد از اعتبارسنجی
duration_sec
مدت واقعی اجرا (ثانیه)
qc_pass_pct
نسبت قبولی کنترل کیفیت
alerts[]
انحراف، مهلت، احراز هویت
sample_record
نمونه رکورد برای پذیرش
داده نمایشی — اعداد واقعی نیستند. ساختار نهایی در امضای پروژه ثبت میشود. دسترسپذیری منبع سرویس بیرونی ضمانت نمیشود.
{
  "run_id": "2025-06-26T08:00:00Z",
  "source": "portal-internal",
  "pipeline": ["discovery", "extract", "validate", "store", "alert"],
  "records_ok": 842,
  "records_failed": 3,
  "duration_sec": 1240,
  "qc_pass_pct": 99.6,
  "alerts": [{"type": "selector_drift", "field": "price", "severity": "warn"}],
  "sample_record": {"id": "X-99", "field_a": "value", "scraped_at": "2025-06-26T08:19:40Z"}
}ادامه مسیر
پیوندهای داخلی و منابع
برای API، پلتفرم، اتوماسیون و اصول فنی اطراف خط استخراج.
درون سایت
- همه سرویسها فهرست کامل خدمات WebScraper.ir
- توسعه API درگاه REST برای خروجی ذخیره
- اتوماسیون گردش کار هشدار، گزارش و یکپارچهسازی
- توسعه پلتفرم وقتی ربات استخراج بخش یک محصول بزرگتر است
- راهنمای استخراج از وب پایه فنی و حقوقی جمعآوری داده
منابع بیرونی
- مستندات Playwright انگلیسی — مرجع خودکارسازی مرورگر
- مستندات Scrapy انگلیسی — خزش و توان عملیاتی
فنی
ابزارها، زمانبندی و محدودیتها
Python
هسته استخراج و هماهنگی خط
Playwright
برنامه تکصفحهای، ورود و رندر
Scrapy
خزش با توان عملیاتی بالا
PostgreSQL
ذخیره و گزارش اجرا
محدودیتهای واقعی
- CAPTCHA و ضدربات سخت بدون مسیر فنی پایدار در امکانسنجی
- تغییر ناگهانی چیدمان و انحراف انتخابگر
- محدودیت درخواست و ضدربات منبع
- ورود با احراز هویت دو مرحلهای با فرآیند امنیتی سنگین
- نیاز به نگهداری مداوم پس از تحویل اول
تحویل سورس ≠ بدون SLA — انحراف و بهروزرسانی در قرارداد نگهداری تعریف میشود.
زمانبندی اجرا
cron ساده تا Celery با صف پردازشگر — بسته به حجم و محدودسازی نرخ توافقی در معماری.
SLA روی خط و زیرساخت استقرار ماست — تغییر چیدمان منبع در قرارداد نگهداری جدا شفاف میشود.
محدوده پروژه و استفاده از داده
روش استخراج بر اساس معماری منبع، حجم داده و محدودیتهای فنی در قرارداد تعریف میشود.
WebScraper.ir مشاور حقوقی نیست — مسئولیت استفاده نهایی از داده با مشتری است.
محدوده تحویل، فیلدها و SLA در امکانسنجی قبل از مقیاسدهی شفاف میشود.
داده حساس سازمانی فقط با کنترل دسترسی توافقشده پردازش میشود.
پرسشهای متداول
پرسشهای رایج قبل از قرارداد
در مدل توافقی بله — مخزن در Git شما یا خصوصی با مستندات اجرا.
معمولاً بهازای منبع یا پروفایل — چند منبع در یک قرارداد با امکانسنجی جدا.
چکلیست N رکورد نمونه که تیم شما قبل از مقیاسدهی امضا میکند.
ابتدا ساختار منبع و نوع محدودیت (WAF، CAPTCHA، نشست) بررسی میشود؛ ابزار و معماری بر اساس آن انتخاب میشود — اگر مسیر فنی پایدار نباشد در امکانسنجی شفاف میگوییم.
با هماهنگی امنیتی — گاهی نیمهدستی یا اطلاعات ورود اختصاصی لازم است.
بر اساس پویایی صفحه و توان عملیاتی — در گزارش امکانسنجی توضیح میدهیم.
cron، Celery یا محرک دستی — نرخ درخواست با SLA و رفتار منبع در معماری تنظیم میشود.
قرارداد SLA جدا — بهروزرسانی انتخابگر و پایش انحراف.
بله — اغلب کنار سرویس توسعه API در یک معماری.
روی زیرساخت WebScraper.ir یا استقرار روی VPS/سرور شما — در قرارداد.
خیر — دسترسپذیری و چیدمان سایت بیرونی خارج از کنترل ماست؛ هشدار و SLA خط داخلی.
با tunnel و اطلاعات ورود سازمان شما — محدوده امنیت در امکانسنجی ثبت میشود.
گام بعد
آدرس نمونه، خروجی مدنظر و محدودیت منبع را دارید؟
بفرستید — ابتدا منبع و ساختار داده بررسی میشود؛ سپس پایلوت روی نمونه واقعی و مدل تحویل (سورس، اجرا روی سرور یا نگهداری قراردادی) را مشخص میکنیم.